


JAK BUDOWAĆ ODPORNE MODELE AI?
Niewidzialny atak na AI
Jak perturbacja, której nie zauważy człowiek, oszukuje model i dlaczego AI Act czyni to problemem zarządu?
Artykuł otwiera serię poświęconą bezpieczeństwu systemów sztucznej inteligencji oraz zagadnieniom związanym z adversarial machine learning. Materiał powstał na podstawie pracy dyplomowej MBA w zakresie Cyberbezpieczeństwa, realizowanej w Wojskowej Akademii Technicznej i stanowi syntetyczne przedstawienie najważniejszych wniosków oraz rekomendacji praktycznych.
Twój model uczenia maszynowego może zostać oszukany zmianą danych wejściowych, której ludzkie oko w ogóle nie zauważy. To problem, który dotyczy coraz większej liczby systemów sztucznej inteligencji (AI) wykorzystywanych w biznesie. To nie teoria, lecz dobrze udokumentowane zjawisko, które unijny AI Act przenosi z laboratoriów wprost do obowiązków prawnych organizacji. W tym artykule pokażę, czym są ataki antagonistyczne, dlaczego są ryzykiem biznesowym, a nie tylko technicznym oraz jak ująć je w gotowej macierzy ryzyka.

Jak działają ataki antagonistyczne na modele AI?
W 2014 r. zespół Christiana Szegedy’ego opublikował wyniki badań, które do dziś pozostają jednym z najczęściej przywoływanych przykładów podatności modeli AI. Dodanie do obrazu minimalnego, precyzyjnie policzonego szumu potrafi zmienić decyzję klasyfikatora, mimo że dla człowieka obraz wygląda identycznie. Tak zmodyfikowane dane nazywamy przykładami antagonistycznymi (ang. adversarial examples).
Mechanika jest zaskakująco prosta do sformalizowania. Mamy poprawnie działający model uczenia maszynowego, który dla wejścia x zwraca właściwą klasę. Atakujący szuka najmniejszej możliwej perturbacji δ, takiej, że model dla x + δ myli się, przy czym δ jest na tyle mała, że pozostaje niedostrzegalna.
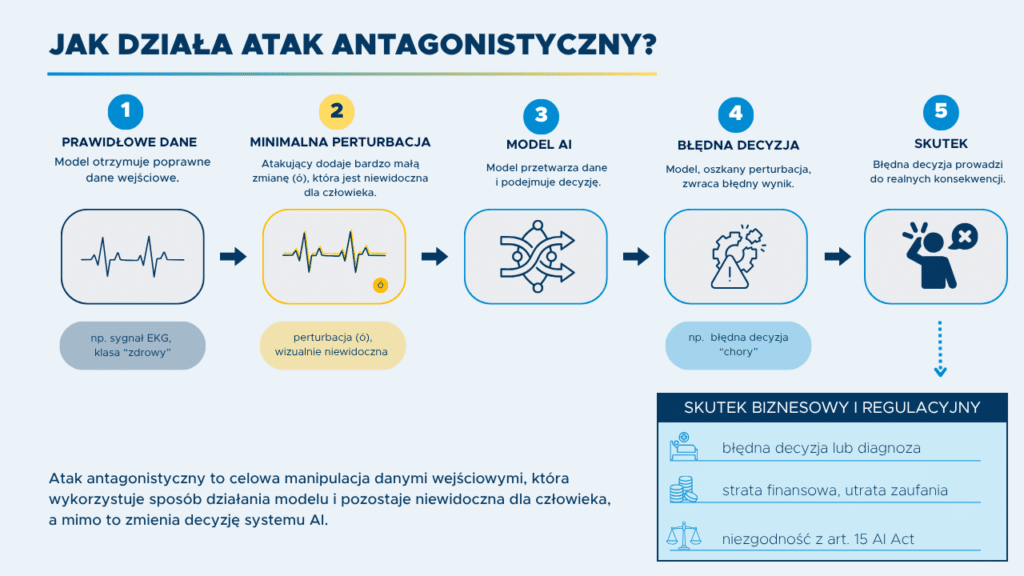
Prawidłowe wejście → + perturbacja δ → MODEL AI → Błędna decyzja
(np. sygnał EKG, klasa „zdrowy”) → (‖δ‖ ≤ ε, wizualnie niewidoczna) → (fałszywa klasyfikacja „chory”)
SKUTEK BIZNESOWY / PRAWNY
• błędna diagnoza lub decyzja
• strata finansowa, utrata zaufania
• niezgodność z art. 15 AI Act
Kluczowa różnica względem „zwykłego” błędu modelu polega na intencji. To nie przypadkowa pomyłka statystyczna, lecz celowa manipulacja wykorzystująca sposób, w jaki sieć neuronowa liczy gradienty. Model nie „widzi” świata tak jak my, a atakujący dokładnie o tym wie.
Dlaczego bezpieczeństwo AI jest dziś problemem biznesowym?
Dopóki modele ML służyły do rekomendacji filmów, konsekwencje błędu były niewielkie. Dziś te same architektury podejmują decyzje w medycynie, biometrii, infrastrukturze krytycznej i systemach antykorupcyjnych. W tych kontekstach błędna klasyfikacja wywołana perturbacją ma realne skutki: błędną diagnozę EKG, nieautoryzowany dostęp do systemu biometrycznego, przepuszczenie transakcji oszukańczej albo zafałszowanie odczytu z czujnika przemysłowego.
Zmienia to charakter problemu. Podatność antagonistyczna przestaje być zagadnieniem zespołu data science, a staje się ryzykiem organizacyjnym, takim, które ma właściciela, prawdopodobieństwo, skutek i wymaganą kontrolę. Innymi słowy: należy do rejestru ryzyka AI.
W tym miejscu pojawia się również aspekt regulacyjny. Unijny AI Act (Rozporządzenie (UE) 2024/1689) wszedł w życie 1 sierpnia 2024 r. i jest stosowany etapami. Kierunek jest jednak przesądzony: odporność na ataki staje się jednym z kluczowych elementów bezpieczeństwa AI oraz wymogiem prawnym.
AI Act a odporność systemów sztucznej inteligencji
To nie jest ogólnik o „bezpieczeństwie”. Artykuł 15 ust. 1 wymaga, by systemy wysokiego ryzyka osiągały odpowiedni poziom dokładności, odporności (robustness) i cyberbezpieczeństwa oraz utrzymywały go w całym cyklu życia.
Najważniejszy jest jednak artykuł 15 ust. 5, który wprost wymienia zagrożenia z mojej pracy. Nakazuje on stosowanie środków mających zapobiegać, wykrywać i reagować na:
- manipulację zbiorem treningowym (data poisoning),
- manipulację komponentami pretrenowanymi (model poisoning),
- wejścia zaprojektowane tak, by model popełnił błąd, czyli adversarial examples / model evasion,
- ataki na poufność oraz wady modelu.
To rzadki przypadek, gdy akt prawny nazywa techniki ataku dokładnie tak, jak literatura naukowa. Dla organizacji oznacza to jedno: „nie wiedzieliśmy” przestaje być linią obrony.
Jak zarządzać ryzykiem AI w organizacji?
Poniżej przedstawiam uproszczoną macierz, którą można wprost wkleić do rejestru ryzyka AI w organizacji.
Atak FGSM/PGD na klasyfikator sygnału
Podatny zasób: Model produkcyjny (EKG, monitoring)
Skutek biznesowy: Błędna diagnoza / decyzja automatyczna
Prawdopodobieństwo: Wysokie
Kontrola: Augmentacja danych + monitoring dystrybucji
Właściciel: CISO / Kierownik AI
Atak CW na model uwierzytelniający
Podatny zasób: System biometryczny
Skutek biznesowy: Nieautoryzowany dostęp
Prawdopodobieństwo: Średnie
Kontrola: Trening odpornościowy, detektor anomalii
Właściciel: Architekt Bezpieczeństwa
Square Attack na API modelu
Podatny zasób: API ML
Skutek biznesowy: Manipulacja wynikami usługi
Prawdopodobieństwo: Wysokie
Kontrola: Rate limiting, monitoring rozkładu zapytań
Właściciel: DevSecOps / PM
Data poisoning
Podatny zasób: Zbiór treningowy
Skutek biznesowy: Trwałe osłabienie modelu
Prawdopodobieństwo: Niskie
Kontrola: Weryfikacja proweniencji, audyt danych
Właściciel: Menedżer ds. Danych
Trzy najczęstsze błędy, które obserwuję w podejściu organizacji do tego tematu:
- Traktowanie modelu jak zwykłego oprogramowania. Klasyczne testy bezpieczeństwa (pentest API, skan podatności) nie wykryją podatności, która tkwi w gradientach modelu.
- Brak właściciela ryzyka. Bez przypisania odpowiedzialności (CISO, architekt, menedżer danych) temat „wisi” między zespołami.
- Odkładanie tematu do czasu wejścia regulacji. Dług odpornościowy, podobnie jak techniczny, kumuluje się, a retrofit odporności w modelu produkcyjnym jest droższy niż zaprojektowanie jej od początku.
Warto też osadzić to w uznanym standardzie. NIST AI Risk Management Framework (AI RMF 1.0, 2023) porządkuje pracę w cztery funkcje: Govern, Map, Measure, Manage i w podkategorii MEASURE 2.7 wprost wymaga, by bezpieczeństwo i odporność systemów AI były oceniane i dokumentowane. To naturalny pomost między wymogiem prawnym (AI Act) a praktyką inżynierską.
Co oznaczają ataki antagonistyczne dla firm?
Ataki antagonistyczne to mierzalne ryzyko dla każdej organizacji wdrażającej systemy sztucznej inteligencji (AI) w procesach o realnej stawce. AI Act, w szczególności art. 15 ust. 5, nazywa te zagrożenia wprost i wymaga aktywnych środków obrony, a NIST AI RMF daje ramy do ich udokumentowania. Dobra wiadomość jest taka, że zwiększanie odporności modeli nie musi oznaczać kosztownych wdrożeń. W kolejnych częściach pokażę, że nawet relatywnie proste techniki potrafią znacząco ograniczyć podatność systemów na tego typu ataki.
W części 2/4 rozłożę atak na czynniki pierwsze i wyjaśnię, dlaczego najpopularniejsza „ciężka” obrona bywa nieopłacalna oraz co można zastosować zamiast niej.
AUTOR:
Piotr Hawryło – Software Team Leader z ponad 10-letnim doświadczeniem w obszarze systemów embedded. Jest absolwentem MBA z cyberbezpieczeństwa na Wojskowej Akademii Technicznej. Brał udział w projektach z zakresu uczenia maszynowego, m.in. związanych z poszukiwaniem planet pozasłonecznych. Specjalizuje się w rozwoju oprogramowania na urządzenia wbudowane i posiada doświadczenie w zarządzaniu zespołami technicznymi.


